Migrations de base de données à chaud : étendre, puis contracter, avec une limite de retour arrière claire
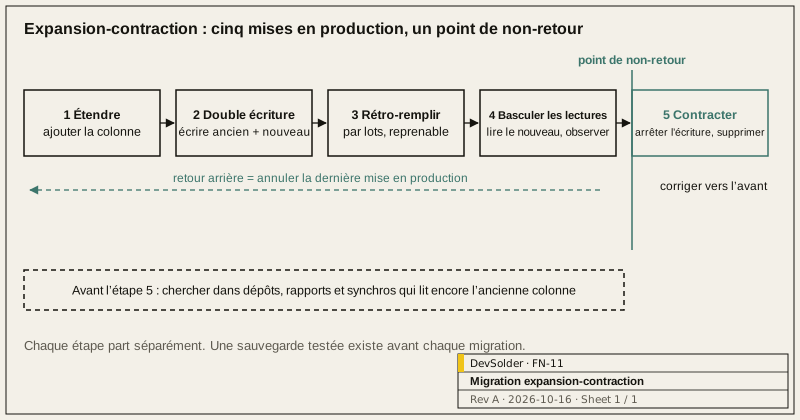
EN BREF : Quand on modifie un schéma en production, le danger tient rarement au SQL lui-même, mais à la période où l’ancienne et la nouvelle version du code tournent côte à côte. Nous procédons par expansion-contraction : ajouter sans retirer pour que les deux versions fonctionnent, rétro-remplir l’historique par lots, basculer les lectures, et ne supprimer l’ancienne structure qu’une fois que plus rien ne l’utilise. Chaque étape est une mise en production distincte. Jusqu’à la suppression, le retour arrière reste possible à tout moment ; après, on ne peut que corriger vers l’avant.
1.0 Pourquoi pas en une seule fois
Pendant un déploiement progressif, d’anciennes instances servent encore des requêtes, et des applications mobiles ou des systèmes externes peuvent encore appeler l’ancienne interface. Une migration qui renomme une colonne casse immédiatement l’ancien code pas encore retiré. Certaines DDL sur de grosses tables tiennent en outre des verrous longtemps et font patienter les requêtes ordinaires derrière elles.
2.0 Les cinq étapes
| Étape | Ce qui se passe | Réversible ? |
|---|---|---|
| 1 Étendre | Ajouter la nouvelle colonne ou table, nullable ou avec valeur par défaut ; l’ancienne structure n’est pas touchée | Oui, supprimer la nouvelle colonne |
| 2 Double écriture | Le nouveau code écrit dans l’ancienne et la nouvelle ; les lectures restent sur l’ancienne | Oui, annuler le code |
| 3 Rétro-remplissage | Copier l’historique dans la nouvelle structure par lots, de façon réentrante et interruptible | Oui |
| 4 Basculer les lectures | Les lectures passent sur la nouvelle structure et sont observées un temps ; l’ancienne est toujours écrite | Oui, rebasculer |
| 5 Contracter | Cesser d’écrire l’ancienne structure, puis la supprimer | Plus après la suppression |
Avant l’étape 5, marquez un temps d’arrêt et vérifiez qu’aucun code, rapport ou synchronisation externe ne lit encore l’ancienne colonne. Nous le vérifions par une recherche dans tous les dépôts et dans les journaux d’accès à la base, pas de mémoire.
3.0 Le rétro-remplissage
- Travailler par plages de clé primaire, une transaction courte par lot et une pause entre les lots, pour éviter les longues transactions et le retard de réplication.
- Rendre le rétro-remplissage réentrant : après une interruption il reprend là où il s’était arrêté, et l’exécuter deux fois donne le même résultat.
- Consigner la progression et les lignes en échec, et traiter ces dernières à part pour qu’une ligne défectueuse ne bloque pas tout le traitement.
- Les nouvelles écritures pendant le rétro-remplissage sont déjà couvertes par la double écriture ; le rétro-remplissage ne s’occupe que de l’historique.
4.0 Les opérations qui verrouillent les tables
Les bases et leurs versions diffèrent beaucoup ; lisez la documentation officielle avant de commencer. Quelques cas fréquents :
- Sous PostgreSQL, créez les index avec CREATE INDEX CONCURRENTLY pour ne pas bloquer les écritures. Cette commande ne peut pas s’exécuter dans un bloc de transaction, et un échec laisse un index invalide à supprimer puis recréer.
- Pour ajouter une colonne NOT NULL à une table déjà remplie, ajoutez-la d’abord en nullable, rétro-remplissez, puis posez la contrainte.
- Sous MySQL, vérifiez pour votre version quelles opérations le DDL en ligne prend en charge, et avec quel algorithme ; pour les grosses tables, envisagez un outil comme gh-ost.
- Fixez un délai d’attente de verrou pour la session de migration. Si elle n’obtient pas le verrou, elle doit échouer et réessayer plus tard, et non attendre dans la file des verrous en bloquant toutes les requêtes suivantes.
5.0 Les migrations dans la CI et le processus de mise en production
- Les fichiers de migration sont numérotés dans l’ordre et conservés dans le dépôt. Une migration déjà livrée n’est jamais modifiée ; une erreur se corrige par une nouvelle migration.
- La CI emprunte deux chemins : toutes les migrations sur une base vide, et les nouvelles migrations sur une base à l’état de la dernière mise en production. Les deux doivent aboutir au même schéma.
- Avant la mise en production, exécutez la migration sur une copie anonymisée des données de production et notez sa durée, pour décider s’il faut la placer en période creuse.
- Chaque migration est précédée d’une sauvegarde exploitable dont la restauration a été testée. Une sauvegarde jamais restaurée ne compte pas.
Si un système existant a besoin d’un changement de schéma important, ou si les migrations posent régulièrement problème, voir Web, cloud et gestion des équipements, ou parlez-nous de votre projet.
Références
- Martin Fowler, Parallel Change : https://martinfowler.com/bliki/ParallelChange.html
- PostgreSQL, CREATE INDEX : https://www.postgresql.org/docs/current/sql-createindex.html
- gh-ost : https://github.com/github/gh-ost
Questions fréquentes
Un petit projet a-t-il vraiment besoin de toutes ces étapes ?
Si une courte fenêtre de maintenance est acceptable et qu'aucun client ne dépend encore de l'ancienne interface, arrêter le service et modifier la table est plus simple et tout à fait correct. L'expansion-contraction s'adresse aux systèmes qui ne peuvent pas s'arrêter, ou dans lesquels ancien et nouveau code tourneront forcément en même temps.
La double écriture peut-elle laisser des données incohérentes ?
Le risque existe. Avant de basculer les lectures, on compare par échantillonnage anciennes et nouvelles données, puis, après le rétro-remplissage, on compare intégralement les champs clés une fois de plus. Quand les deux écritures peuvent partager une transaction, on les y met.
Peut-on utiliser telles quelles les migrations générées par l'ORM ?
Elles font un bon premier jet, mais quelqu'un doit relire le SQL généré avant la mise en production, surtout pour les renommages, changements de type et suppressions. Les outils transforment souvent un renommage en suppression puis création de colonne, et les données disparaissent.
Et si une migration échoue à mi-parcours ?
Avant l'étape 5, on annule la dernière mise en production et l'on revient au point de départ. Une structure déjà supprimée ne se récupère que depuis une sauvegarde ou par une correction vers l'avant ; c'est pourquoi la suppression vient en dernier, dans une mise en production à part, après un temps d'observation suffisant.