Datenbankmigrationen im laufenden Betrieb: erst erweitern, dann zurückbauen, mit klarer Rollback-Grenze
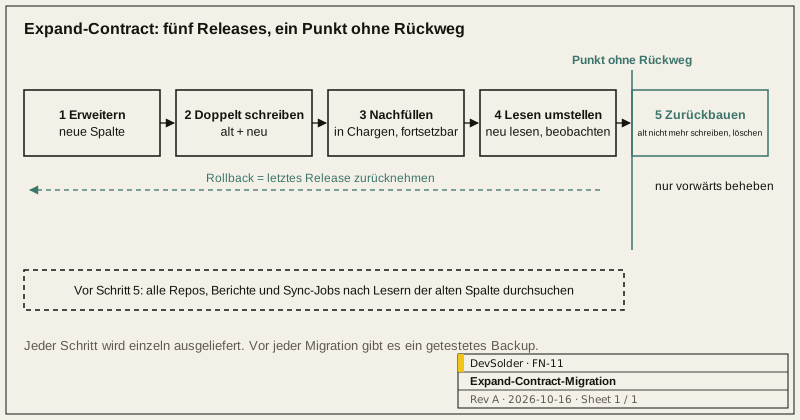
KURZ GESAGT: Bei Schemaänderungen in Produktion ist selten das SQL selbst gefährlich, sondern die Phase, in der alte und neue Codeversion nebeneinander laufen. Wir arbeiten nach Expand-Contract: hinzufügen, ohne zu entfernen, damit beide Versionen funktionieren; historische Daten in Chargen nachfüllen; Lesezugriffe umstellen; die alte Struktur erst löschen, wenn sie niemand mehr nutzt. Jeder Schritt ist ein eigenes Release. Bis zum Löschen ist jederzeit ein Rollback möglich, danach nur noch eine Korrektur nach vorn.
1.0 Warum nicht in einem Schritt
Während eines Rolling Deployments bedienen alte Instanzen noch Anfragen, und Mobile Apps oder externe Systeme rufen womöglich noch die alte Schnittstelle auf. Eine Migration, die eine Spalte umbenennt, bricht den noch nicht abgelösten alten Code sofort. Manche DDL auf großen Tabellen hält außerdem lange Sperren und staut normale Anfragen dahinter.
2.0 Die fünf Schritte
| Schritt | Was passiert | Umkehrbar? |
|---|---|---|
| 1 Erweitern | Neue Spalte oder Tabelle anlegen, nullable oder mit Default; die alte Struktur bleibt unberührt | Ja, neue Spalte löschen |
| 2 Doppelt schreiben | Neuer Code schreibt in alt und neu; gelesen wird weiter aus der alten Struktur | Ja, Code zurücknehmen |
| 3 Nachfüllen | Historische Daten in Chargen übertragen, wiederholbar und pausierbar | Ja |
| 4 Lesen umstellen | Lesezugriffe gehen auf die neue Struktur und werden eine Weile beobachtet; die alte wird noch beschrieben | Ja, zurückschalten |
| 5 Zurückbauen | Schreiben in die alte Struktur beenden, dann löschen | Nach dem Löschen nicht |
Vor Schritt 5 innehalten und bestätigen, dass kein Code, kein Bericht und keine externe Synchronisierung die alte Spalte noch liest. Wir prüfen das mit einer Suche über alle Repositories und mit den Datenbank-Zugriffslogs, nicht aus dem Gedächtnis.
3.0 Nachfüllen
- In Primärschlüsselbereichen arbeiten, eine kurze Transaktion je Charge mit Pause dazwischen, um lange Transaktionen und Replikationsverzug zu vermeiden.
- Das Nachfüllen wiederholbar machen: Nach einer Unterbrechung setzt es dort fort, wo es aufhörte, und zweimaliges Ausführen liefert dasselbe Ergebnis.
- Fortschritt und fehlgeschlagene Zeilen protokollieren und Fehler separat behandeln, damit eine kaputte Zeile nicht das ganze Nachfüllen blockiert.
- Neue Schreibvorgänge während des Nachfüllens deckt das doppelte Schreiben bereits ab; das Nachfüllen kümmert sich nur um die Historie.
4.0 Operationen, die Tabellen sperren
Datenbanken und Versionen unterscheiden sich stark, also vorher die offizielle Dokumentation lesen. Einige häufige Fälle:
- Unter PostgreSQL Indizes mit CREATE INDEX CONCURRENTLY anlegen, damit Schreibzugriffe nicht blockiert werden. Das geht nicht innerhalb eines Transaktionsblocks, und ein Fehlschlag hinterlässt einen ungültigen Index, der gelöscht und neu angelegt werden muss.
- Um einer befüllten Tabelle eine NOT-NULL-Spalte hinzuzufügen, sie zunächst nullable anlegen, nachfüllen und dann die Bedingung ergänzen.
- Bei MySQL für die eingesetzte Version prüfen, welche Operationen Online-DDL mit welchem Algorithmus unterstützt; für große Tabellen ein Werkzeug wie gh-ost in Betracht ziehen.
- Für die Migrationssitzung ein Lock-Timeout setzen. Bekommt sie die Sperre nicht, soll sie scheitern und später erneut versuchen, statt in der Sperrwarteschlange alle folgenden Anfragen zu blockieren.
5.0 Migrationen in CI und Release-Prozess
- Migrationsdateien sind fortlaufend nummeriert und liegen im Repository. Eine ausgelieferte Migration wird nie geändert; Fehler behebt eine neue Migration.
- Die CI fährt zwei Wege: alle Migrationen auf einer leeren Datenbank und die neuen Migrationen auf einer Datenbank im Stand des letzten Releases. Beide müssen dasselbe Schema ergeben.
- Vor dem Release die Migration auf einer geschwärzten Kopie der Produktionsdaten laufen lassen und die Dauer notieren, um zu entscheiden, ob sie in eine ruhige Zeit gehört.
- Vor jeder Migration gibt es ein brauchbares Backup, dessen Wiederherstellung geprobt wurde. Ein nie wiederhergestelltes Backup zählt nicht.
Wenn ein bestehendes System eine größere Schemaänderung braucht oder Migrationen immer wieder Ärger machen, siehe Web, Cloud und Geräteverwaltung, oder Projekt besprechen.
Quellen
- Martin Fowler, Parallel Change: https://martinfowler.com/bliki/ParallelChange.html
- PostgreSQL, CREATE INDEX: https://www.postgresql.org/docs/current/sql-createindex.html
- gh-ost: https://github.com/github/gh-ost
Häufige Fragen
Braucht ein kleines Projekt wirklich all diese Schritte?
Ist ein kurzes Wartungsfenster akzeptabel und hängt kein Client mehr an der alten Schnittstelle, ist es einfacher und völlig in Ordnung, den Dienst anzuhalten und die Tabelle zu ändern. Expand-Contract ist für Systeme gedacht, die nicht anhalten können, oder bei denen alter und neuer Code zwangsläufig gleichzeitig laufen.
Kann doppeltes Schreiben inkonsistente Daten erzeugen?
Das Risiko besteht. Vor dem Umstellen der Lesezugriffe werden alte und neue Daten stichprobenartig verglichen, nach dem Nachfüllen die Schlüsselfelder noch einmal vollständig. Wo beide Schreibvorgänge in eine Transaktion passen, gehören sie in dieselbe.
Können wir vom ORM erzeugte Migrationen unverändert verwenden?
Als erster Entwurf taugen sie, aber vor dem Release sollte jemand das erzeugte SQL lesen, besonders bei Umbenennungen, Typänderungen und Löschungen. Werkzeuge machen aus einer Umbenennung oft „Spalte löschen, Spalte anlegen“, und die Daten sind weg.
Was, wenn eine Migration mittendrin scheitert?
Vor Schritt 5 nehmen Sie das letzte Release zurück und sind wieder am Ausgangspunkt. Eine bereits gelöschte Struktur lässt sich nur aus dem Backup wiederherstellen oder vorwärts reparieren; deshalb kommt das Löschen zuletzt, als eigenes Release und nach ausreichender Beobachtungszeit.