Mettre en production des fonctions LLM : prompts versionnés, jeux d'évaluation et portes de régression
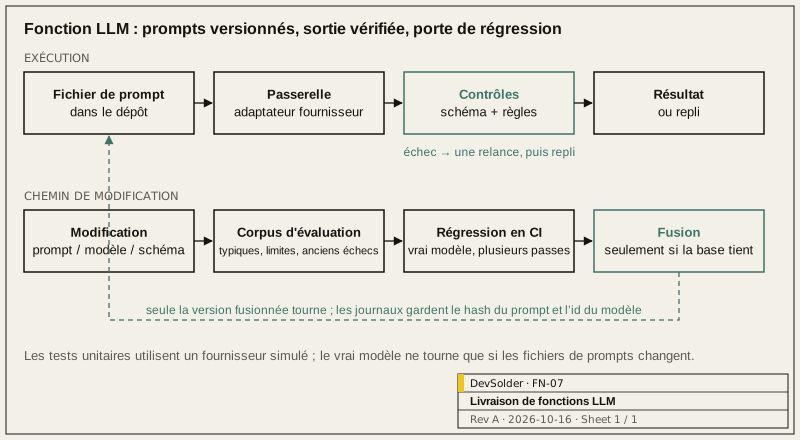
EN BREF : Quand une fonction LLM se comporte mal en production, le modèle est rarement en cause. Le plus souvent, quelqu’un a modifié le prompt à la volée, personne n’a validé le format de sortie, ou le modèle a changé sans que personne ne reteste. Nous gérons les prompts comme du code, vérifions chaque sortie avec un schéma et des règles métier avant toute utilisation en aval, tenons un jeu d’évaluation par fonction et lançons une régression en CI à chaque changement de prompt ou de modèle. Si le score baisse, la modification n’est pas fusionnée.
1.0 Pourquoi ça marche en démo et dérive en production
En démo, tout est entre les mains de celui qui l’a construite : le prompt est dans son éditeur, il a choisi les entrées et voit d’un coup d’œil si la réponse est bonne. La production supprime tout cela :
- Les prompts sont éparpillés entre des chaînes dans le code, un panneau d’administration et des notes personnelles, et personne ne sait quelle version est en ligne.
- La sortie est du texte libre que le code en aval analyse comme « probablement du JSON », jusqu’au jour où le modèle ajoute une phrase de politesse.
- Le fournisseur publie une nouvelle version du modèle, le même prompt se comporte autrement, et personne ne s’en aperçoit.
- Il n’y a pas d’entrées de test fixes, donc « mieux ou moins bien » relève de l’opinion.
2.0 Les prompts vivent dans le dépôt
Un fichier par prompt, stocké dans le dépôt et relu avec le code qui l’appelle. L’en-tête indique l’objectif, les variables d’entrée, la structure de sortie attendue et le modèle visé. Si deux fournisseurs demandent des formulations différentes, utilisez deux fichiers plutôt que des branches conditionnelles dans un même modèle.
Les journaux d’exécution enregistrent le hash du fichier de prompt et l’identifiant du modèle, si bien que toute sortie peut être rattachée au prompt et au modèle exacts qui l’ont produite.
Nous déconseillons de rendre les prompts modifiables depuis un panneau d’administration. Cela paraît souple, mais contourne la revue et les tests et modifie directement la logique de production. Si l’exploitation doit vraiment ajuster quelque chose, comme le ton ou des exemples de texte, exposez-le sous forme de quelques paramètres bornés, pas le prompt entier.
3.0 Vérifier la sortie avant toute utilisation
| Couche | Rôle |
|---|---|
| Structure | Demander une sortie structurée et la valider avec un JSON Schema ou un type équivalent ; en cas d’échec, une relance puis le repli |
| Règles métier | Du code déterministe vérifie les valeurs d’énumération, les plages, les champs obligatoires et l’existence réelle des identifiants référencés |
| Sécurité | Une couche locale de mots-clés et de règles qui ne dépend pas du bon comportement du modèle ; une correspondance suit un traitement fixe |
| Repli | Ce que reçoit l’utilisateur en cas de timeout, de limitation de débit ou d’échec de validation est décidé à l’avance et couvert par des tests |
Ce que du code déterministe peut trancher reste hors du modèle. Si une grille de notation comporte des pénalités fixes, un moteur de règles les calcule, et le modèle fait ce qu’il sait faire : comprendre, résumer, rédiger. Les résultats deviennent reproductibles et la question « pourquoi ai-je perdu des points ? » a une réponse.
4.0 Jeux d’évaluation et porte de régression
Chaque fonction a son jeu d’évaluation : entrées typiques, cas limites et entrées qui ont déjà posé problème. Chaque élément porte des assertions sur la structure, les champs clés et les contenus qui ne doivent pas apparaître. La qualité subjective est notée par un modèle selon une grille, et une personne vérifie périodiquement que cette notation est fiable.
Ces changements déclenchent une régression en CI : le prompt, le schéma de sortie, le modèle ou sa version, et le code d’analyse. Le seuil est écrit à l’avance, par exemple un taux d’assertions réussies au moins égal à la dernière base de référence, et une modification qui le manque n’est pas fusionnée. La sortie d’un modèle n’est pas déterministe : exécuter chaque entrée plusieurs fois et mesurer la cohérence en dit plus qu’une seule passe.
Les appels réels coûtent de l’argent et du temps, d’où deux niveaux. Les tests unitaires quotidiens utilisent un fournisseur simulé qui renvoie des données déterministes, ce qui permet de faire tourner toute la chaîne hors ligne. La régression des prompts utilise le vrai modèle et ne tourne que si des fichiers liés aux prompts changent.
5.0 Fournisseurs et coûts
- La passerelle a un adaptateur par fournisseur et le code métier n’importe jamais le SDK d’un fournisseur. Changer de fournisseur ou en ajouter un de secours ne touche que l’adaptateur.
- Figez les modèles sur un instantané précis, pas sur un alias comme latest. Une montée de version du modèle est une mise en production et passe d’abord par la régression.
- Enregistrez la consommation de tokens par fonction et appliquez les quotas côté serveur, jamais d’après des chiffres déclarés par le client.
- Si le système doit être auto-hébergé, choisissez un serveur d’inférence avec une API compatible OpenAI, comme vLLM, et utilisez un serveur simulé local pendant le développement pour que le code client ne change pas.
6.0 Ce que vous recevez
- Les fichiers de prompts et leur historique de modifications.
- Les schémas de sortie, les contrôles de règles et les chemins de repli, avec leurs tests.
- Les jeux d’évaluation, les grilles, la configuration de régression en CI et les scores de la base de référence actuelle.
- La couche d’adaptateurs fournisseurs et les relevés de consommation.
Pour ajouter des fonctions d’IA à un produit nouveau ou existant, voir Web, cloud et gestion des équipements. Pour parler de votre situation, passez par Parler de votre projet.
Références
- Documentation promptfoo : https://www.promptfoo.dev/docs/intro/
- vLLM, serveur compatible OpenAI : https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
Questions fréquentes
Quelle taille doit avoir un jeu d'évaluation ?
Commencez par les entrées réelles dont vous disposez déjà et par les cas qui ont déjà posé problème. Couvrir les scénarios principaux et les modes de défaillance connus suffit à attraper la plupart des régressions. Ensuite, chaque incident de production ajoute son entrée : le jeu grandit avec les problèmes au lieu de viser l'exhaustivité dès le premier jour.
Peut-on faire confiance à un modèle pour noter un autre modèle ?
Avec une grille bien rédigée, il convient pour trier de gros volumes, mais l'évaluateur a ses propres biais. Une personne contrôle régulièrement les notes par échantillonnage, et tout critère sur lequel l'évaluateur diverge durablement des humains passe en contrôle par règles ou en revue humaine.
Quel travail faut-il pour passer à un modèle moins cher ?
Tout dépend de l'existence du jeu d'évaluation. S'il existe, changer revient à modifier la configuration de l'adaptateur, lancer la régression et comparer scores et coûts ; on voit précisément où se situe l'écart. Sinon, le construire est la première étape.
Le fournisseur du modèle va-t-il entraîner ses modèles sur nos données ?
Cela dépend des conditions d'utilisation des données du fournisseur et du contrat que vous signez, à vérifier dès la sélection. Pour des données sensibles, on recourt en général à un serveur d'inférence auto-hébergé ou à l'anonymisation avant que la requête ne quitte votre système.