Llevar funciones con LLM a producción: prompts versionados, conjuntos de evaluación y puertas de regresión
EN BREVE: Cuando una función con LLM falla en producción, el modelo rara vez es la causa. Lo normal es que alguien haya editado el prompt sobre la marcha, que nadie validara el formato de salida o que el modelo cambiara sin que nadie volviera a probar. Gestionamos los prompts como código, validamos cada salida con un esquema y reglas de negocio antes de que la use nada más, mantenemos un conjunto de evaluación por función y ejecutamos una regresión en CI cada vez que cambia un prompt o un modelo. Si la puntuación baja, el cambio no se fusiona.
1.0 Por qué funciona en la demo y deriva en producción
En una demo todo está en manos de quien la construyó: el prompt está en su editor, las entradas las eligió esa persona y sabe de un vistazo si la respuesta es buena. Producción elimina todo eso:
- Los prompts están repartidos entre cadenas en el código, un panel de administración y notas personales, y nadie sabe qué versión está activa.
- La salida es texto libre que el código posterior interpreta como “probablemente JSON”, y se rompe la primera vez que el modelo añade una frase amable.
- El proveedor publica una versión nueva del modelo, el mismo prompt se comporta distinto y nadie se da cuenta.
- No hay entradas de prueba fijas, así que “mejor o peor” es cuestión de opinión.
2.0 Los prompts viven en el repositorio
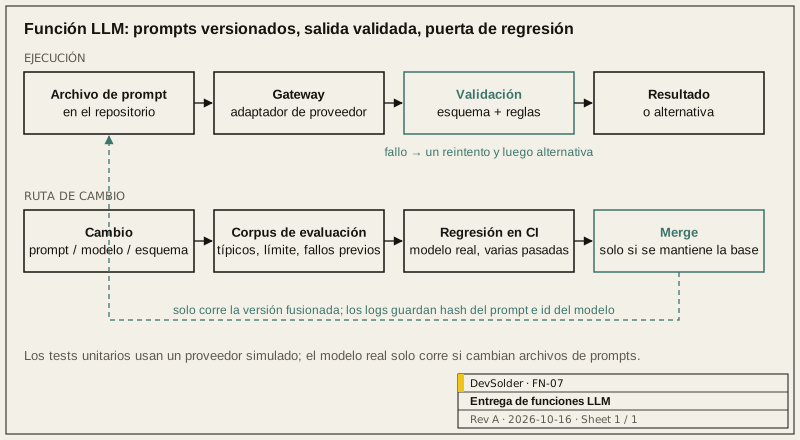
Un archivo por prompt, guardado en el repositorio y revisado junto con el código que lo llama. La cabecera indica el propósito, las variables de entrada, la estructura de salida esperada y el modelo de destino. Si dos proveedores necesitan redacciones distintas, use dos archivos en lugar de ramas condicionales dentro de una plantilla.
Los logs de ejecución registran el hash del archivo de prompt y el identificador del modelo, de modo que cualquier salida se puede rastrear hasta el prompt y el modelo exactos que la produjeron.
Desaconsejamos que los prompts se puedan editar desde un panel de administración. Parece flexible, pero se salta la revisión y las pruebas y cambia directamente la lógica de producción. Si el equipo de operaciones necesita de verdad ajustar algo, como el tono o los textos de ejemplo, expóngalo como unos pocos parámetros acotados, no como el prompt entero.
3.0 Validar la salida antes de que nadie la use
| Capa | Qué hace |
|---|---|
| Estructura | Pedir salida estructurada y validarla con un JSON Schema o un tipo equivalente; ante un fallo, un reintento y después alternativa |
| Reglas de negocio | Código determinista comprueba valores de enumeración, rangos, campos obligatorios y que los ID referenciados existan de verdad |
| Seguridad | Una capa local de palabras clave y reglas que no depende de que el modelo se comporte; una coincidencia sigue un flujo fijo |
| Alternativa | Qué recibe el usuario ante un timeout, un límite de peticiones o una validación fallida se decide de antemano y se cubre con pruebas |
Lo que pueda decidir código determinista no se le pasa al modelo. Si una rúbrica tiene descuentos fijos, los calcula un motor de reglas y el modelo hace lo que sabe hacer: entender, resumir y generar. Los resultados son reproducibles y la pregunta “¿por qué perdí puntos?” tiene respuesta.
4.0 Conjuntos de evaluación y puerta de regresión
Cada función tiene su conjunto de evaluación: entradas típicas, casos límite y entradas que dieron problemas antes. Cada elemento lleva aserciones sobre la estructura, los campos clave y el contenido que no debe aparecer. La calidad subjetiva la califica un modelo con una rúbrica, y una persona comprueba periódicamente que esa calificación sea fiable.
Estos cambios disparan una regresión en CI: el prompt, el esquema de salida, el modelo o su versión y el código de análisis. El umbral se fija por escrito antes, por ejemplo una tasa de aserciones superadas no inferior a la última línea base, y un cambio que no lo cumple no se fusiona. La salida del modelo no es determinista, así que ejecutar cada entrada varias veces y medir la consistencia dice más que una sola pasada.
Las llamadas reales cuestan dinero y tiempo, por eso hay dos niveles. Las pruebas unitarias diarias usan un proveedor simulado que devuelve datos deterministas, de modo que toda la cadena funciona sin conexión. La regresión de prompts usa el modelo real y solo se ejecuta cuando cambian archivos relacionados con los prompts.
5.0 Proveedores y coste
- El gateway tiene un adaptador por proveedor y el código de negocio nunca importa el SDK de un proveedor. Cambiar de proveedor o añadir uno de respaldo solo toca el adaptador.
- Fije los modelos a una instantánea concreta, no a un alias como latest. Actualizar el modelo es un despliegue y pasa primero por la regresión.
- Registre el consumo de tokens por función y aplique las cuotas en el servidor, nunca con cifras que reporta el cliente.
- Si el sistema debe alojarse internamente, elija un servidor de inferencia con API compatible con OpenAI, como vLLM, y use un servidor simulado local durante el desarrollo para que el código cliente no cambie.
6.0 Qué recibe
- Los archivos de prompt y su historial de cambios.
- Esquemas de salida, comprobaciones de reglas y rutas alternativas, con sus pruebas.
- Conjuntos de evaluación, rúbricas, la configuración de regresión en CI y las puntuaciones de la línea base actual.
- La capa de adaptadores de proveedor y los registros de consumo.
Para añadir funciones de IA a un producto nuevo o existente, consulte Web, nube y gestión de dispositivos. Para hablar de su caso concreto, use Hablar de un proyecto.
Referencias
- Documentación de promptfoo: https://www.promptfoo.dev/docs/intro/
- vLLM, servidor compatible con OpenAI: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
Preguntas frecuentes
¿Qué tamaño debe tener un conjunto de evaluación?
Empiece con las entradas reales que ya tiene y con los casos que ya fallaron alguna vez. Cubrir los escenarios principales y los modos de fallo conocidos ya detecta la mayoría de las regresiones. Después, cada incidente en producción añade su entrada; el conjunto crece con los problemas en lugar de intentar ser completo el primer día.
¿Se puede confiar en que un modelo califique a otro?
Con una rúbrica bien escrita sirve para cribar grandes lotes, pero el evaluador tiene sus propios sesgos. Una persona revisa las calificaciones por muestreo con regularidad, y cualquier criterio en el que el evaluador discrepe sistemáticamente de las personas pasa a comprobaciones con reglas o a revisión humana.
¿Cuánto trabajo cuesta cambiar a un modelo más barato?
Depende de si existe el conjunto de evaluación. Si existe, cambiar consiste en modificar la configuración del adaptador, ejecutar la regresión y comparar puntuaciones y coste; se ve exactamente dónde está la diferencia. Si no existe, crearlo es el primer paso.
¿Usará el proveedor del modelo nuestros datos para entrenar?
Lo determinan las condiciones de datos del proveedor y el contrato que firme, y conviene comprobarlo al elegir proveedor. Con datos sensibles, lo habitual es un servidor de inferencia propio o anonimizar antes de que la petición salga de su sistema.