LLM-Funktionen ausliefern: versionierte Prompts, Eval-Sets und Regressions-Gates
KURZ GESAGT: Wenn eine LLM-Funktion in Produktion danebenliegt, ist selten das Modell schuld. Meist wurde der Prompt nebenbei geändert, niemand hat das Ausgabeformat geprüft, oder das Modell hat sich geändert und niemand hat nachgetestet. Wir verwalten Prompts wie Code, prüfen jede Ausgabe gegen Schema und Geschäftsregeln, bevor sie weiterverarbeitet wird, pflegen pro Funktion ein Eval-Set und lassen bei jeder Prompt- oder Modelländerung eine Regression in der CI laufen. Sinkt der Wert, wird nicht gemergt.
1.0 Warum es in der Demo funktioniert und in Produktion wegdriftet
In der Demo liegt alles bei dem, der sie gebaut hat: Der Prompt steht in seinem Editor, die Eingaben hat er ausgewählt, und ob die Antwort gut ist, sieht er auf einen Blick. In Produktion fällt das alles weg:
- Prompts verteilen sich auf Code-Strings, ein Admin-Panel und persönliche Notizen; welche Version live ist, weiß niemand genau.
- Die Ausgabe ist Freitext, den nachgelagerter Code als „wahrscheinlich JSON“ parst, bis das Modell einmal einen höflichen Satz voranstellt.
- Der Anbieter liefert eine neue Modellversion aus, derselbe Prompt verhält sich anders, und es fällt niemandem auf.
- Es gibt keine festen Testeingaben, also ist „besser oder schlechter“ Ansichtssache.
2.0 Prompts gehören ins Repository
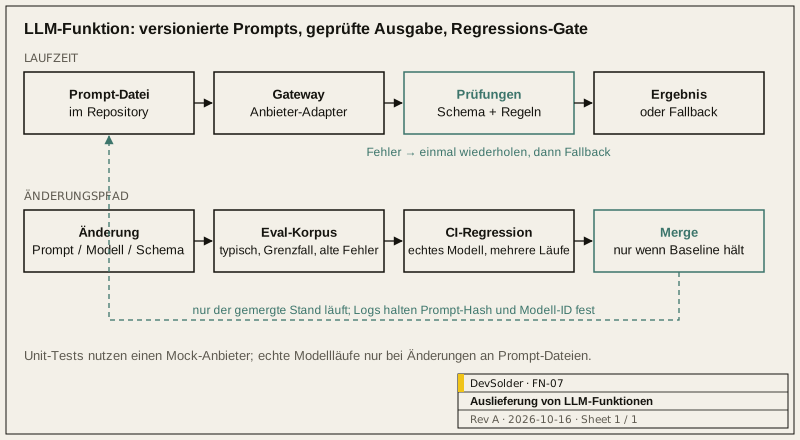
Eine Datei pro Prompt, im Repository abgelegt und zusammen mit dem aufrufenden Code reviewt. Der Kopf nennt Zweck, Eingabevariablen, erwartete Ausgabestruktur und Zielmodell. Brauchen zwei Anbieter unterschiedliche Formulierungen, nehmen Sie zwei Dateien statt Verzweigungen in einer Vorlage.
Die Laufzeit-Logs halten den Hash der Prompt-Datei und die Modellkennung fest. So lässt sich jede Ausgabe dem genauen Prompt und Modell zuordnen.
Prompts im Admin-Panel frei editierbar zu machen, raten wir ab. Es wirkt flexibel, umgeht aber Review und Tests und ändert die Produktionslogik direkt. Muss der Betrieb etwas anpassen, etwa Tonfall oder Beispieltexte, stellen Sie dafür wenige begrenzte Parameter bereit, nicht den ganzen Prompt.
3.0 Ausgabe prüfen, bevor sie jemand verwendet
| Ebene | Aufgabe |
|---|---|
| Struktur | Strukturierte Ausgabe anfordern und gegen ein JSON Schema oder einen gleichwertigen Typ validieren; bei Fehlern einmal wiederholen, dann Fallback |
| Geschäftsregeln | Deterministischer Code prüft Enum-Werte, Wertebereiche, Pflichtfelder und ob referenzierte IDs tatsächlich existieren |
| Sicherheit | Eine lokale Schicht aus Schlüsselwörtern und Regeln, die sich nicht auf das Wohlverhalten des Modells verlässt; ein Treffer folgt einem festen Ablauf |
| Fallback | Was der Nutzer bei Timeout, Rate-Limit oder fehlgeschlagener Validierung bekommt, ist vorab festgelegt und getestet |
Was deterministischer Code entscheiden kann, bleibt beim Code. Hat eine Bewertungsskala feste Abzüge, rechnet sie eine Regel-Engine aus, und das Modell übernimmt, was es gut kann: verstehen, zusammenfassen, formulieren. Die Ergebnisse werden reproduzierbar, und die Frage „Warum habe ich Punkte verloren?“ hat eine Antwort.
4.0 Eval-Sets und das Regressions-Gate
Jede Funktion bekommt ein Eval-Set: typische Eingaben, Grenzfälle und Eingaben, die früher Probleme gemacht haben. Jeder Eintrag hat Assertions zu Struktur, Schlüsselfeldern und Inhalten, die nicht vorkommen dürfen. Subjektive Qualität bewertet ein Modell anhand einer Skala, und ein Mensch prüft regelmäßig, ob diese Bewertung selbst stimmt.
Folgende Änderungen lösen einen Regressionslauf in der CI aus: Prompt, Ausgabeschema, Modell oder Modellversion und Parsing-Code. Die Schwelle steht vorher fest, etwa eine Assertion-Quote nicht unter der letzten Baseline; wer sie verfehlt, wird nicht gemergt. Modellausgaben sind nicht deterministisch, darum sagt es mehr, jede Eingabe mehrmals laufen zu lassen und die Konsistenz zu prüfen, als einen einzelnen Durchlauf.
Echte Aufrufe kosten Geld und Zeit, deshalb gibt es zwei Ebenen. Die täglichen Unit-Tests nutzen einen Mock-Anbieter mit deterministischen Daten, sodass die ganze Kette offline läuft. Die Prompt-Regression nutzt das echte Modell und läuft nur, wenn sich promptbezogene Dateien ändern.
5.0 Anbieter und Kosten
- Das Gateway hat einen Adapter pro Anbieter; Geschäftscode importiert nie ein Anbieter-SDK. Ein Anbieterwechsel oder ein Fallback-Anbieter betrifft nur den Adapter.
- Modelle auf einen konkreten Snapshot festlegen, nicht auf einen Alias wie latest. Ein Modell-Upgrade ist ein Release und läuft zuerst durch die Regression.
- Token-Verbrauch pro Funktion erfassen und Kontingente auf dem Server durchsetzen, nie anhand von Zahlen, die der Client meldet.
- Muss das System selbst betrieben werden, einen Inferenzserver mit OpenAI-kompatibler API wählen, etwa vLLM, und in der Entwicklung einen lokalen Mock-Server verwenden, damit sich der Client-Code nicht ändert.
6.0 Was Sie bekommen
- Die Prompt-Dateien mit ihrer Änderungshistorie.
- Ausgabeschemas, Regelprüfungen und Fallback-Pfade, jeweils mit Tests.
- Eval-Sets, Bewertungsskalen, die CI-Regressionskonfiguration und die aktuellen Baseline-Werte.
- Die Adapterschicht für Anbieter und die Verbrauchsaufzeichnung.
Für KI-Funktionen in einem neuen oder bestehenden Produkt siehe Web, Cloud und Geräteverwaltung. Über Ihre konkrete Lage sprechen wir gern: Projekt besprechen.
Quellen
- promptfoo-Dokumentation: https://www.promptfoo.dev/docs/intro/
- vLLM, OpenAI-kompatibler Server: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
Häufige Fragen
Wie groß muss ein Eval-Set sein?
Beginnen Sie mit den echten Eingaben, die Sie schon haben, und den Fällen, die bereits schiefgegangen sind. Wer die Hauptszenarien und die bekannten Fehlerbilder abdeckt, fängt die meisten Regressionen ab. Jeder Produktionsvorfall fügt danach seine Eingabe hinzu; das Set wächst mit den Problemen, statt am ersten Tag vollständig sein zu wollen.
Kann man einem Modell trauen, das ein anderes Modell bewertet?
Mit klar formulierter Bewertungsskala eignet es sich gut, um große Mengen vorzusortieren, hat aber eigene Verzerrungen. Wir lassen die Bewertungen regelmäßig von Menschen stichprobenartig prüfen; Kriterien, bei denen Modell und Mensch dauerhaft auseinanderliegen, wandern in regelbasierte Prüfungen oder in die manuelle Begutachtung.
Wie aufwendig ist der Wechsel auf ein günstigeres Modell?
Das hängt davon ab, ob es ein Eval-Set gibt. Wenn ja, heißt Wechseln: Adapter-Konfiguration ändern, Regression laufen lassen, Ergebnisse und Kosten vergleichen; wo die Lücke liegt, sieht man sofort. Wenn nicht, ist das Eval-Set der erste Schritt.
Trainiert der Modellanbieter mit unseren Daten?
Das regeln die Datenbedingungen des Anbieters und Ihr Vertrag, und es gehört in die Anbieterauswahl. Bei sensiblen Daten sind selbst betriebene Inferenzserver oder eine Schwärzung vor dem Versand die üblichen Wege.