Webhooks idempotents : clés, relances et effets de bord
EN BREF : La plupart des émetteurs relancent en cas de timeout, de 5xx ou de coupure réseau ; les autres comptent sur un renvoi manuel. Chaque livraison est at-least-once : une clé par événement, l’état de traitement persisté avant tout effet de bord, et une table de déduplication couvrant la durée maximale de relance. Une clé déjà terminée reçoit 2xx.
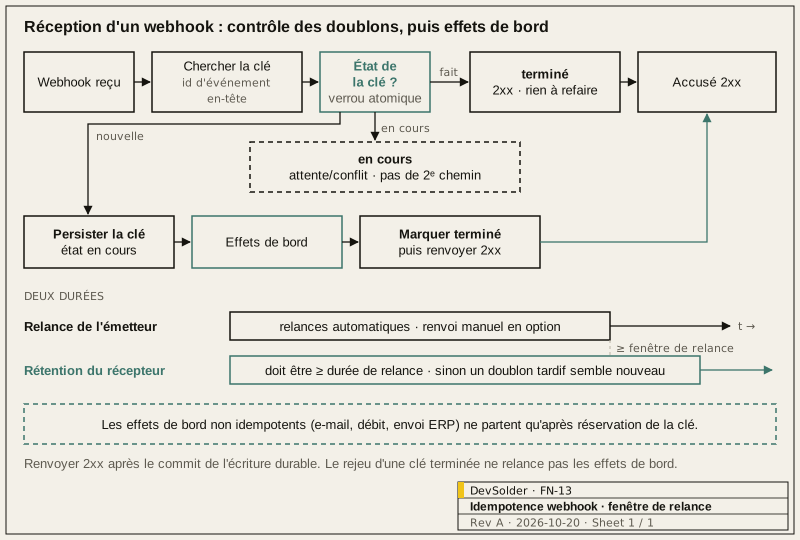
1.0 L’émetteur relance ; le récepteur doit partir du principe at-least-once
Un webhook tombé en timeout chez vous a peut-être déjà été appliqué. L’émetteur n’en sait rien, donc il relance. Une réponse 500 ou une simple panne réseau produit le même effet. Concevoir comme si chaque événement arrivait exactement une fois, c’est s’exposer aux e-mails en double, aux mouvements de stock comptés deux fois ou à deux pièces ERP pour un seul paiement.
La durée pendant laquelle un fournisseur insiste varie beaucoup. Stripe, par exemple, relance les livraisons de webhooks en mode live jusqu’à trois jours avec un backoff exponentiel. GitHub ne relance pas automatiquement les livraisons échouées ; tout ce qui date des trois derniers jours peut être renvoyé depuis l’interface ou l’API. Lisez ce que le fournisseur documente sur les relances et le renvoi, et dimensionnez la rétention de déduplication sur la fenêtre la plus longue qui compte pour vous. Le pari « on répond vite, donc il n’y aura pas de relance » ne tient pas.
2.0 Une clé stable
| Source | Clé courante | Remarques |
|---|---|---|
| Id d’événement du fournisseur | evt_…, GUID de livraison | À privilégier s’il est unique par événement logique |
| Composite | (provider, event_id) | Quand un même système reçoit les webhooks de plusieurs fournisseurs |
| En-tête | Idempotency-Key, X-GitHub-Delivery | Idempotency-Key sert à vos propres API sortantes. GitHub conserve le même GUID X-GitHub-Delivery lors d’un renvoi : il identifie l’événement, pas la tentative |
| Objet métier | (event_type, object_id) | Nécessaire si le fournisseur peut émettre deux objets Event pour le même changement |
Stockez la clé avec une contrainte d’unicité (ou via une écriture conditionnelle atomique). Le cas délicat, c’est la concurrence : deux workers peuvent tous deux constater « absent » si l’insertion elle-même ne sert pas de verrou.
3.0 Un état plutôt qu’un drapeau « fait »
| État | Sens | Si la même clé est livrée à nouveau |
|---|---|---|
| processing | Accepté, traitement en cours (bail / propriétaire en option) | Attendre, renvoyer un conflit ou se rattacher à la tentative en cours ; ne pas lancer un second chemin d’effets de bord |
| completed | Persisté, effets de bord faits | Renvoyer 2xx tout de suite ; aucun effet de bord |
| failed_retryable | Échec temporaire ; on peut réessayer sans risque | Réessayer avec backoff, toujours sous la même clé |
| failed_terminal | Ne passera pas sans intervention humaine | Alerter ; ne pas boucler indéfiniment en automatique |
L’état processing s’écrit dans la même écriture durable que celle qui accepte la clé pour la première fois, avant tout e-mail, débit ou appel ERP. L’état completed ne s’écrit qu’une fois que ces effets de bord ont leur propre trace durable (ou que la ligne d’outbox qui va les déclencher est validée).
4.0 Fenêtre de relance et rétention de déduplication
Deux durées doivent concorder :
- La fenêtre de relance de l’émetteur : pendant combien de temps le fournisseur (ou votre script de renvoi) peut renvoyer le même événement.
- La rétention de déduplication du récepteur : pendant combien de temps vous gardez clés et résultats pour reconnaître un doublon tardif.
La rétention doit être supérieure ou égale à la fenêtre de relance que vous acceptez. Si les clés expirent avant, une relance tardive a l’air nouvelle. Le renvoi manuel remonte souvent plus loin : Stripe relance automatiquement jusqu’à trois jours, mais le Dashboard permet de renvoyer un événement pendant 15 jours et la CLI pendant 30. Si l’exploitation renvoie encore depuis le tableau de bord une fois votre rétention écoulée, soit vous allongez la rétention, soit vous exigez une nouvelle clé et un rapprochement explicite.
5.0 Persister avant d’acquitter
Le cas pénible : votre handler a fini le travail, puis la connexion tombe avant que l’émetteur ait vu le 2xx. L’émetteur relance. Si le succès n’était gardé qu’en mémoire, les effets de bord repartent une deuxième fois.
Voici l’ordre dans lequel nous écrivons :
- Écrire d’abord l’événement (ou une ligne d’outbox) et l’état processing / completed.
- Ne renvoyer 2xx qu’après le commit de cette écriture.
- Déclencher les effets de bord non idempotents depuis l’enregistrement durable, après le contrôle des doublons.
- Si les effets de bord sont lents, acquitter dès l’acceptation durable et les terminer en asynchrone, toujours sous la même clé et la même machine à états.
6.0 Les effets de bord passent derrière le verrou
Tout ce qui se défait mal (envoyer un e-mail, débiter une carte, pousser une pièce dans l’ERP, ouvrir un ticket) ne s’exécute qu’après avoir réservé la clé. Les rejeux d’une clé completed sautent ce chemin et renvoient un succès. Si l’effet de bord n’est pas idempotent côté destinataire, donnez-lui sa propre clé métier (numéro de commande, id de facture) pour qu’un second envoi ne crée pas une seconde pièce.
7.0 L’ordre en livraison at-least-once
Les fournisseurs garantissent rarement l’ordre. Un événement updated peut arriver avant created, ou la relance d’un ancien payload peut suivre un payload plus récent. L’idempotence seule n’y change rien. Gardez une version, une séquence ou un updated_at par objet métier et ignorez les écritures périmées, ou récupérez la ressource courante auprès du fournisseur avant de modifier l’état local.
8.0 Ce qu’il faut journaliser et surveiller
- Indexer la table de déduplication par clé, pour que « a-t-on déjà traité
evt_…? » tienne en une requête. - Journaliser chaque tentative : clé, résultat (doublon / en cours / terminé / échec), latence, numéro de tentative.
- Les données de paiement ou personnelles restent hors des logs partagés ; nous journalisons une empreinte et notre id interne.
- Alerter sur les clés bloquées en processing au-delà du bail, et sur les pics soudains de doublons (souvent une rafale de relances de l’émetteur après une panne).
Si vous construisez des récepteurs de webhooks pour le paiement, l’ERP ou des clouds d’équipements, voir Web, cloud et gestion des équipements, ou parlez-nous de votre projet.
Références
- Stripe, Receive Stripe events in your webhook endpoint : https://docs.stripe.com/webhooks
- Stripe, Idempotent requests : https://docs.stripe.com/api/idempotent_requests
- GitHub, Best practices for using webhooks : https://docs.github.com/en/webhooks/using-webhooks/best-practices-for-using-webhooks
- GitHub, Redelivering webhooks : https://docs.github.com/en/webhooks/testing-and-troubleshooting-webhooks/redelivering-webhooks
- IETF HTTPAPI WG, The Idempotency-Key HTTP Header Field, draft-ietf-httpapi-idempotency-key-header-07 (Internet-Draft expiré) : https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
Questions fréquentes
Notre fournisseur affirme livrer chaque événement une seule fois. Faut-il quand même une table de déduplication ?
Le contrat courant est at-least-once : timeouts, réponses 5xx et micro-coupures réseau déclenchent des relances. C'est une clé stable, avec une rétention qui couvre la durée maximale de relance du fournisseur, qui évite de doubler les effets de bord quand la même charge utile (payload) revient.
Que répondre si un doublon arrive alors que la première tentative est encore en cours ?
Un conflit ou un signal d'attente courte, selon ce que documente l'émetteur, mais jamais un second chemin d'effets de bord pour la même clé. Nous gardons la ligne à l'état processing avec un bail (propriétaire et échéance), et ne la passons à completed qu'une fois la persistance et les effets de bord terminés.
Combien de temps conserver les clés déjà traitées ?
Au moins aussi longtemps que la fenêtre de relance automatique de l'émetteur, et de préférence jusqu'au bout de la période de renvoi manuel qu'il publie. Si une clé expire et que le même événement revient, le récepteur le prend pour un nouvel événement et risque de refaire un travail non idempotent.
Nous avons déjà renvoyé 200, mais l'e-mail ou l'envoi vers l'ERP n'est jamais parti. Comment rattraper ?
Il faut persister l'événement et son état de traitement avant de renvoyer 2xx, puis piloter les effets de bord depuis cet enregistrement durable ou depuis une outbox. Si l'on répond succès avant que l'écriture soit validée, une panne locale juste après ne laisse rien à partir de quoi reprendre, alors que l'émetteur considère l'événement comme livré.
Les événements arrivent parfois dans le désordre. La clé d'idempotence règle-t-elle le problème ?
La clé empêche seulement d'appliquer deux fois le même événement. L'ordre demande ses propres règles : ignorer les versions périmées grâce à un numéro de séquence ou à updated_at, ou récupérer l'objet courant via l'API du fournisseur avant de modifier l'état local.