Idempotencia en webhooks: claves, reintentos y efectos
EN BREVE: La mayoría de los emisores reintenta ante timeouts, 5xx y cortes de red; el resto espera que usted reenvíe. Trate cada entrega como at-least-once: una clave por evento, el estado de proceso persistido antes de los efectos secundarios y las claves guardadas al menos lo que dure el plazo máximo de reintentos. Una clave ya completada solo recibe 2xx.
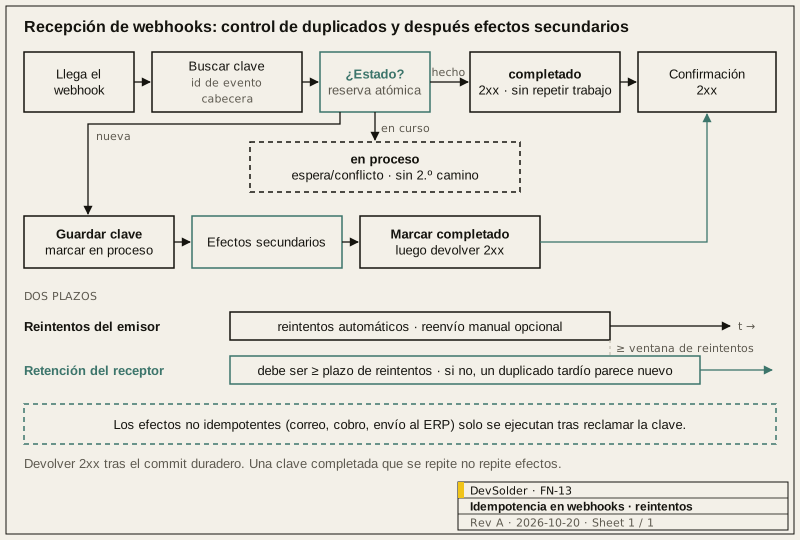
1.0 El emisor reintenta; el receptor debe asumir at-least-once
Un webhook que agotó el timeout de su lado puede haberse aplicado ya. El emisor no lo sabe, así que lo reintenta. Con las respuestas 500 y con los fallos de red sin más pasa lo mismo. Si se diseña pensando que cada evento llega exactamente una vez, acaban apareciendo correos duplicados, movimientos de stock dobles o dos documentos en el ERP para un solo pago.
Cada proveedor insiste durante un tiempo distinto. Stripe, por ejemplo, reintenta las entregas de webhooks en modo activo hasta tres días con backoff exponencial. GitHub no reenvía automáticamente las entregas fallidas; cualquier entrega de los últimos tres días se puede reenviar a mano desde la interfaz o la API. Lea lo que documenta el proveedor sobre reintentos y reenvíos y dimensione la retención de deduplicación según la ventana más larga que le importe. Suponer que “respondemos rápido, así que no habrá reintentos” no sirve.
2.0 Una clave estable
| Origen | Clave habitual | Notas |
|---|---|---|
| Id de evento del proveedor | evt_…, GUID de entrega | Es la primera opción cuando es único por evento lógico |
| Compuesta | (provider, event_id) | Cuando un mismo sistema recibe webhooks de varios proveedores |
| Cabecera | Idempotency-Key, X-GitHub-Delivery | Idempotency-Key sirve para sus propias API salientes. GitHub mantiene el mismo GUID en X-GitHub-Delivery al reenviar, así que identifica el evento, no el intento |
| Objeto de negocio | (event_type, object_id) | Necesaria si el proveedor puede emitir dos objetos Event para el mismo cambio |
Guarde la clave con una restricción de unicidad (o con una escritura condicional atómica). Lo difícil es la concurrencia: dos workers pueden ver “no existe” a la vez si el propio insert no hace de barrera.
3.0 Estados, no una marca de «hecho»
| Estado | Significado | Si llega otra entrega con la misma clave |
|---|---|---|
| processing | Aceptado, trabajo en curso (opcionalmente con lease / propietario) | Esperar, devolver conflicto o engancharse al intento en curso; no abrir un segundo camino de efectos secundarios |
| completed | Persistido y con los efectos secundarios hechos | Devolver 2xx enseguida; sin efectos secundarios |
| failed_retryable | Fallo transitorio; se puede reintentar sin riesgo | Reintentar con backoff, con la misma clave |
| failed_terminal | No saldrá bien sin una persona | Alertar; no dejarlo en bucle automático para siempre |
Marque processing en la misma escritura duradera que acepta la clave por primera vez, antes de cualquier correo, cobro o llamada al ERP. Marque completed solo cuando esos efectos secundarios tengan su propio registro duradero (o cuando se haya confirmado la fila del outbox que los va a disparar).
4.0 Ventana de reintentos frente a retención de deduplicación
Hay dos plazos que deben cuadrar:
- Ventana de reintentos del emisor: cuánto tiempo puede el proveedor (o su propio script de reenvío) volver a enviar el mismo evento.
- Retención de deduplicación del receptor: cuánto tiempo se guardan las claves y los resultados para reconocer un duplicado tardío.
La retención tiene que ser ≥ la ventana de reintentos que acepte. Si las claves caducan antes, un reintento tardío parece nuevo. El reenvío manual suele llegar más atrás: Stripe reintenta de forma automática hasta tres días, pero desde el Dashboard se puede reenviar un evento durante 15 días y con la CLI durante 30. Si operaciones sigue reenviando desde el panel cuando ya venció su retención, amplíe la retención o exija una clave nueva y un proceso explícito de conciliación.
5.0 Persistir antes de confirmar
El caso incómodo es este: el handler terminó el trabajo y la conexión se cortó antes de que el emisor viera el 2xx. El emisor reintenta. Si el éxito solo quedó en memoria, los efectos secundarios se ejecutan dos veces.
El orden en que escribimos:
- Escribir primero el evento (o una fila de outbox) y el estado processing / completed.
- Devolver 2xx solo después del commit de esa escritura.
- Lanzar los efectos secundarios no idempotentes desde el registro duradero, detrás del control de duplicados.
- Si los efectos secundarios tardan, confirmar en cuanto la aceptación sea duradera y terminarlos de forma asíncrona, siempre bajo la misma clave y la misma máquina de estados.
6.0 Los efectos secundarios van detrás de la barrera
Todo lo que cuesta deshacer (enviar un correo, cobrar una tarjeta, mandar un documento al ERP, abrir un ticket) se ejecuta solo después de reclamar la clave. Las repeticiones de una clave completed se saltan ese camino y devuelven éxito. Si el efecto secundario no es idempotente en el otro extremo, dele su propia clave de negocio (número de pedido, id de factura) para que un segundo envío no cree un segundo documento.
7.0 Orden con entrega at-least-once
Los proveedores a menudo no garantizan el orden. Un evento updated puede llegar antes que created, o el reintento de una carga antigua puede llegar después de una más reciente. La idempotencia sola no lo arregla. Guarde una versión, una secuencia o un updated_at por objeto de negocio e ignore las escrituras obsoletas, o consulte el recurso actual en el proveedor antes de cambiar el estado local.
8.0 Qué registrar y cuándo alertar
- Indexar el almacén de deduplicación por clave, para que “¿ya procesamos
evt_…?” sea una sola consulta. - Registrar cada intento: clave, resultado (duplicado / en proceso / completado / fallido), latencia y número de intento.
- Los datos de pago o personales no van a logs compartidos; registramos un digest y nuestro id interno.
- Alertar cuando una clave se quede en processing más allá del lease y ante picos repentinos de duplicados (a menudo una tormenta de reintentos del emisor tras una caída).
Si está construyendo receptores de webhooks para pagos, ERP o nubes de dispositivos, consulte Web, nube y gestión de dispositivos o hable de un proyecto con nosotros.
Referencias
- Stripe, Receive Stripe events in your webhook endpoint: https://docs.stripe.com/webhooks
- Stripe, Idempotent requests: https://docs.stripe.com/api/idempotent_requests
- GitHub, Best practices for using webhooks: https://docs.github.com/en/webhooks/using-webhooks/best-practices-for-using-webhooks
- GitHub, Redelivering webhooks: https://docs.github.com/en/webhooks/testing-and-troubleshooting-webhooks/redelivering-webhooks
- IETF HTTPAPI WG, The Idempotency-Key HTTP Header Field, draft-ietf-httpapi-idempotency-key-header-07 (Internet-Draft caducado): https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
Preguntas frecuentes
Nuestro proveedor dice que entrega cada evento una sola vez. ¿Seguimos necesitando un almacén de deduplicación?
Lo habitual es un contrato at-least-once: los timeouts, las respuestas 5xx y los cortes breves de red disparan reintentos. Una clave estable y una retención que cubra el plazo máximo de reintentos del proveedor es lo que evita efectos secundarios dobles cuando llega otra vez la misma carga.
¿Qué devolvemos si llega un duplicado mientras el primer intento sigue en proceso?
Un conflicto o una señal de espera breve, según lo que documente el emisor, y nunca un segundo camino de efectos secundarios para la misma clave. Nosotros mantenemos la fila en estado processing con un lease (bloqueo con caducidad) y solo la marcamos como completed cuando la persistencia y los efectos secundarios han terminado.
¿Cuánto tiempo hay que guardar las claves procesadas?
Como mínimo, lo que dure la ventana de reintentos automáticos del emisor y, mejor aún, hasta el final del periodo de reenvío manual que publique. Si una clave caduca y el mismo evento vuelve a llegar, el receptor lo tratará como nuevo y puede repetir trabajo no idempotente.
Ya devolvimos 200, pero el correo o el envío al ERP nunca se ejecutó. ¿Cómo lo recuperamos?
Hay que persistir el evento y su estado de proceso antes de devolver 2xx, y lanzar los efectos secundarios desde ese registro duradero o desde un outbox. Si se responde con éxito antes de que la escritura quede confirmada, un fallo local posterior no deja nada desde donde recuperar, y el emisor ya da el evento por entregado.
A veces los eventos llegan desordenados. ¿Lo resuelve la clave de idempotencia?
La clave solo impide aplicar dos veces el mismo evento. El orden necesita reglas propias: descartar versiones antiguas con una secuencia o una comprobación de updated_at, o consultar el objeto actual en la API del proveedor antes de modificar el estado local.