Visibilidad de marca en respuestas de buscadores con IA
Una plataforma de monitorización que muestrea según un calendario las respuestas de varios buscadores con IA, extrae menciones de marca y citas, aplica pruebas estadísticas a los cambios de una semana a otra y los enlaza con diagnósticos, órdenes de trabajo con salvaguardas y atribución.
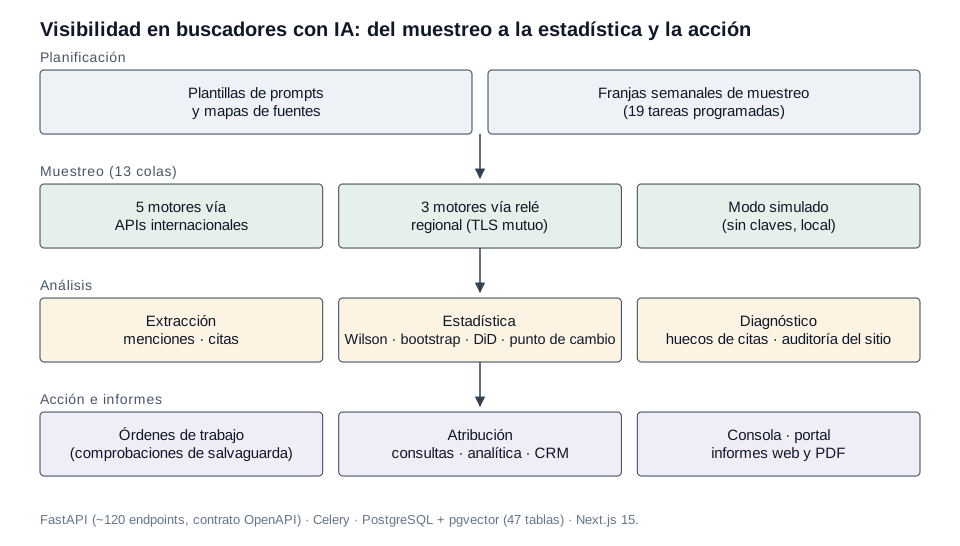
EN BREVE: Construimos una plataforma que lanza los mismos prompts a ocho buscadores con IA según un calendario, extrae menciones de marca y citas, y usa pruebas estadísticas para decidir si un cambio es real antes de que pase a diagnósticos, órdenes de trabajo con salvaguardas, atribución e informes.
Resumen
Los usuarios son exportadores B2B que quieren saber si los buscadores con IA los mencionan y los citan, y si eso cambia después de actuar. Una sola consulta no responde a eso, así que la plataforma está construida en torno al muestreo repetido y a estimaciones de incertidumbre.
Problema
Las respuestas de la IA cambian en cada ejecución. Una consulta aislada dice poco, y las comparaciones ingenuas de antes y después confunden ruido con efecto. Además, algunos buscadores necesitan una ruta de red aparte porque solo son accesibles desde otra región.
Restricciones
- Muestreo repetido con estimaciones de incertidumbre, no observaciones aisladas.
- Tres buscadores accesibles solo a través de un relay en su región, protegido con TLS mutuo.
- Las sugerencias de contenido deben pasar salvaguardas explícitas antes de que nadie actúe sobre ellas.
- El desarrollo local debe funcionar sin ninguna clave de API de proveedor.
Arquitectura
| Parte | Implementación |
|---|---|
| API | FastAPI con unos 120 endpoints bajo un único prefijo versionado; el esquema OpenAPI es el único contrato entre front end y back end |
| Workers | Celery con 13 colas y 19 tareas programadas; la cola del relay funciona con una concurrencia fija de 1 |
| Paquete de dominio | Proveedores, muestreo, resolución, extracción, estadística, diagnóstico, salvaguardas, atribución, informes |
| Datos | PostgreSQL con pgvector, 47 tablas con particiones mensuales; Redis; almacenamiento de objetos compatible con S3 |
| Web | Consola interna en Next.js 15, portal de clientes y rutas de impresión para informes PDF |
| Entrega | Imágenes de contenedor multiarquitectura; CI con lint, comprobación de migraciones, tests, diff del contrato OpenAPI y validación de infraestructura |
Decisiones clave
- La estadística como módulo propio. Intervalos de Wilson, bootstrap por clústeres, diferencias en diferencias y detección de puntos de cambio están en su propio módulo, de modo que cada cambio informado lleva un intervalo y no una simple cifra de antes y después.
- Modo de proveedor simulado por defecto. Todo el pipeline funciona en local sin claves, lo que hace repetibles los tests y las demos y deja los costes de proveedor fuera del desarrollo.
- Salvaguardas sobre las acciones. Una orden de trabajo solo se emite tras superar las comprobaciones de salvaguarda, así que ninguna sugerencia llega sin revisar a un equipo de contenidos.
Evidencias
- Las cifras anteriores (endpoints, colas, tareas programadas, tablas, buscadores) proceden del código y de la configuración del repositorio.
Límites
No se publican resultados de clientes, mejoras de visibilidad ni cifras de atribución. Los métodos estadísticos se describen aquí, no se han validado con datos de clientes.
Preguntas frecuentes
¿Por qué muestrear varias veces en lugar de comprobar una sola vez?
Las respuestas de la IA varían de una ejecución a otra. Muestrear repetidamente con intervalos de confianza muestra si un cambio es mayor que la variación normal.
¿Qué buscadores cubre?
Ocho: cinco a través de APIs internacionales y tres a través de un relay regional. Los nombres de los proveedores dependen del despliegue y no se indican aquí.
¿Puede atribuir consultas a la visibilidad en IA?
La plataforma tiene conectores de atribución para formularios de consulta, analítica web, CRM y tráfico sin atribuir. Este caso no afirma nada sobre resultados de atribución.