Markensichtbarkeit in KI-Suchantworten messen
Eine Monitoring-Plattform, die nach Zeitplan Antworten mehrerer KI-Suchmaschinen stichprobenartig abfragt, Markennennungen und Quellenangaben extrahiert, Veränderungen von Woche zu Woche statistisch prüft und sie mit Diagnose, abgesicherten Arbeitsaufträgen und Attribution verknüpft.
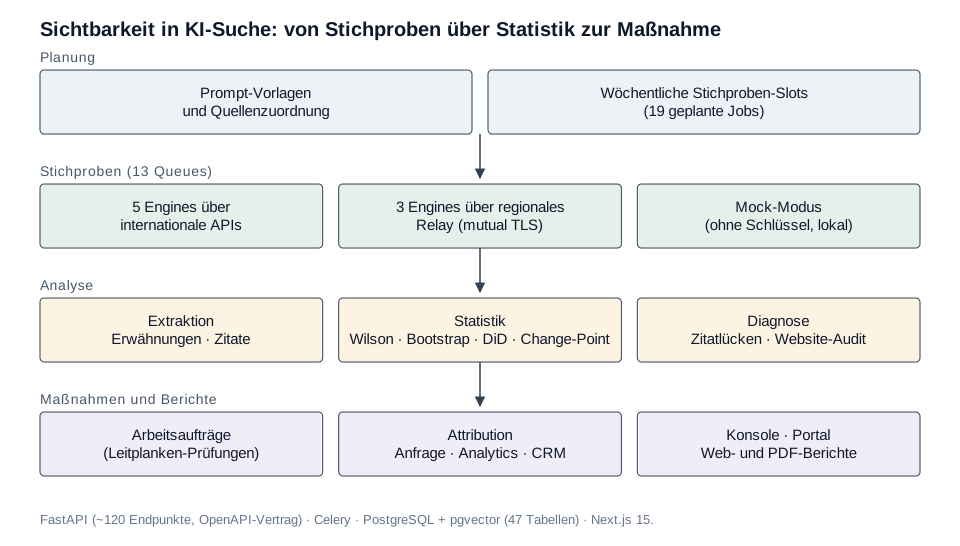
KURZ GESAGT: Wir haben eine Plattform gebaut, die dieselben Prompts nach Zeitplan an acht KI-Suchmaschinen stellt, Markennennungen und Quellenangaben extrahiert und mit statistischen Tests entscheidet, ob eine Veränderung echt ist, bevor sie in Diagnose, abgesicherte Arbeitsaufträge, Attribution und Berichte einfließt.
Überblick
Die Nutzer sind B2B-Exporteure, die wissen wollen, ob KI-Suchmaschinen sie nennen und zitieren und ob sich das ändert, nachdem sie etwas unternommen haben. Eine einzelne Abfrage kann das nicht beantworten, deshalb ist die Plattform um wiederholte Stichproben und Unsicherheitsschätzungen herum gebaut.
Problem
KI-Antworten ändern sich von Lauf zu Lauf. Eine einzelne Abfrage zeigt wenig, und naive Vorher-nachher-Vergleiche verwechseln Rauschen mit Wirkung. Manche Suchmaschinen brauchen außerdem einen eigenen Netzwerkpfad, weil sie nur aus einer anderen Region erreichbar sind.
Randbedingungen
- Wiederholte Stichproben mit Unsicherheitsschätzungen statt Einzelbeobachtungen.
- Drei Suchmaschinen nur über ein Relay in der jeweiligen Region erreichbar, abgesichert mit gegenseitigem TLS.
- Inhaltsvorschläge müssen ausdrückliche Schutzregeln passieren, bevor jemand danach handelt.
- Lokale Entwicklung muss ohne einen einzigen Anbieter-API-Schlüssel laufen.
Architektur
| Teil | Umsetzung |
|---|---|
| API | FastAPI mit etwa 120 Endpunkten unter einem versionierten Präfix; das OpenAPI-Schema ist der einzige Vertrag zwischen Frontend und Backend |
| Worker | Celery mit 13 Queues und 19 geplanten Jobs; die Relay-Queue läuft mit fester Nebenläufigkeit 1 |
| Domänenpaket | Anbieter, Stichproben, Auflösung, Extraktion, Statistik, Diagnose, Schutzregeln, Attribution, Berichte |
| Daten | PostgreSQL mit pgvector, 47 Tabellen mit Monatspartitionen; Redis; S3-kompatibler Objektspeicher |
| Web | Interne Konsole in Next.js 15, Kundenportal und Druckrouten für PDF-Berichte |
| Auslieferung | Container-Images für mehrere Architekturen; CI mit Lint, Migrationsprüfung, Tests, OpenAPI-Vertragsdiff und Infrastrukturvalidierung |
Wichtige Entscheidungen
- Statistik als eigenständiges Modul. Wilson-Intervalle, Cluster-Bootstrap, Differenz-von-Differenzen und Change-Point-Erkennung liegen in einem eigenen Modul, sodass jede gemeldete Veränderung ein Intervall trägt statt einer nackten Vorher-nachher-Zahl.
- Mock-Anbietermodus als Standard. Die gesamte Pipeline läuft lokal ohne Schlüssel. Das macht Tests und Demos wiederholbar und hält Anbieterkosten aus der Entwicklung heraus.
- Schutzregeln für Aktionen. Ein Arbeitsauftrag wird erst ausgegeben, wenn er die Schutzregelprüfungen bestanden hat; so erreicht kein Vorschlag ungeprüft ein Content-Team.
Belege
- Die Zahlen oben (Endpunkte, Queues, Zeitpläne, Tabellen, Suchmaschinen) stammen aus Code und Konfiguration des Repositorys.
Grenzen
Kundenergebnisse, Sichtbarkeitszuwächse oder Attributionszahlen werden nicht veröffentlicht. Die statistischen Methoden sind hier beschrieben, nicht an Kundendaten validiert.
Häufige Fragen
Warum wiederholt abfragen statt einmal prüfen?
KI-Antworten schwanken von Lauf zu Lauf. Wiederholte Stichproben mit Konfidenzintervallen zeigen, ob eine Veränderung größer ist als die normale Schwankung.
Welche Suchmaschinen sind abgedeckt?
Acht: fünf über internationale APIs und drei über ein regionales Relay. Die Anbieternamen hängen vom Deployment ab und werden hier nicht genannt.
Kann die Plattform Anfragen der KI-Sichtbarkeit zuordnen?
Die Plattform hat Attributions-Connectoren für Anfrageformulare, Webanalyse, CRM und nicht zugeordneten Traffic. Über Attributionsergebnisse macht dieses Fallbeispiel keine Aussage.