Ramener à une seule les copies divergentes d'un produit de répartition
Un produit de répartition s'était scindé au fil des ans en plusieurs copies qui divergeaient. Sans arrêter le développement, nous l'avons ramené à une base de code de référence par composant et mis en place un processus de modification qui le garde ainsi.
EN BREF : Un produit de répartition s’était scindé en plusieurs copies divergentes, et il arrivait sans cesse qu’on corrige une copie et qu’on en livre une autre. Sans arrêter le développement, nous l’avons ramené à une base de code de référence par composant et mis en place un processus de modification pour qu’il ne se scinde plus.
Vue d’ensemble
Le produit comprend une console web de répartition, une application Android, un backend d’ordres de travail et un backend de rondes. Le regroupement s’est achevé le 2026-08-04, et le développement courant a continué pendant toute la période.
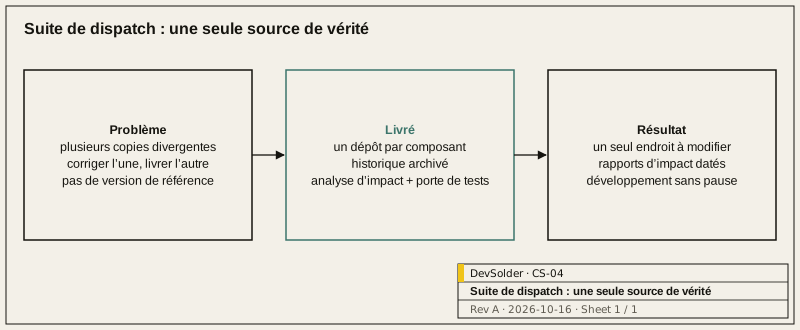
Problème
Avec le temps, chaque composant avait accumulé plusieurs copies. Les modifications étaient reportées à la main de l’une à l’autre, les builds prenaient parfois le mauvais code source, et le même type de défaut revenait sans cesse. Les sauvegardes étaient des dossiers de projet copiés en entier, et personne ne savait laquelle faisait foi. Une archive de code d’un tiers avait été décompressée telle quelle et était devenue une ligne de développement à part.
Ce que nous avons livré
- Une base de code de référence par composant ; l’historique des copies supprimées est archivé et récupérable.
- Une comparaison fichier par fichier du code externe avec la version de référence, en n’intégrant que les vraies modifications et en uniformisant le bruit de formatage.
- Un processus de modification : évaluer d’abord l’impact, commencer chaque correction par un test qui reproduit le défaut, et ne valider qu’après la recette. Les problèmes existants sont recensés et ne peuvent que diminuer.
- Un contrôle automatique avant chaque commit qui empêche des fichiers chiffrés ou corrompus d’entrer dans le code.
Résultat
Chaque composant n’a plus qu’une version qui fait foi, et les builds ne prennent plus le mauvais code source. Chaque modification depuis laisse un rapport d’impact écrit, si bien qu’un problème peut être relié à la modification qui l’a causé.
Limites
Les taux de défauts avant et après n’ont pas été mesurés, et aucun n’est avancé. L’identité du client, la marque du produit et les détails de déploiement ne sont pas publiés.
Questions fréquentes
Pourquoi ne pas tout fusionner dans un seul grand dépôt ?
Les composants avaient déjà leur propre historique et leur propre rythme de livraison. Un dépôt par composant a conservé l'historique complet et a le moins perturbé le travail en cours.
Le code existant a-t-il été nettoyé d'un coup ?
Progressivement. Les problèmes existants sont inscrits dans un registre et chaque entrée ne peut que diminuer, tandis que le nouveau code doit respecter la norme. Les livraisons ont continué et le total ne fait que baisser.
Qu'est-ce qui empêche une deuxième copie de réapparaître ?
Le code venu de l'extérieur est comparé à la version de référence et seules les vraies modifications sont intégrées. Pour garder un état, on pose une étiquette, jamais une copie de dossier.