Hacerse cargo de un código embebido heredado
EN BREVE: Hacerse cargo de firmware heredado empieza por asegurar lo que existe y hacer reproducible la compilación, y después reproducir en una unidad de banco los fallos de campo comunicados. Solo entonces trazamos el mapa del código, ponemos los riesgos por escrito y corregimos primero los problemas más seguros y de mayor valor. Una reescritura solo se plantea cuando las pruebas muestran que la estructura antigua sigue generando fallos nuevos.
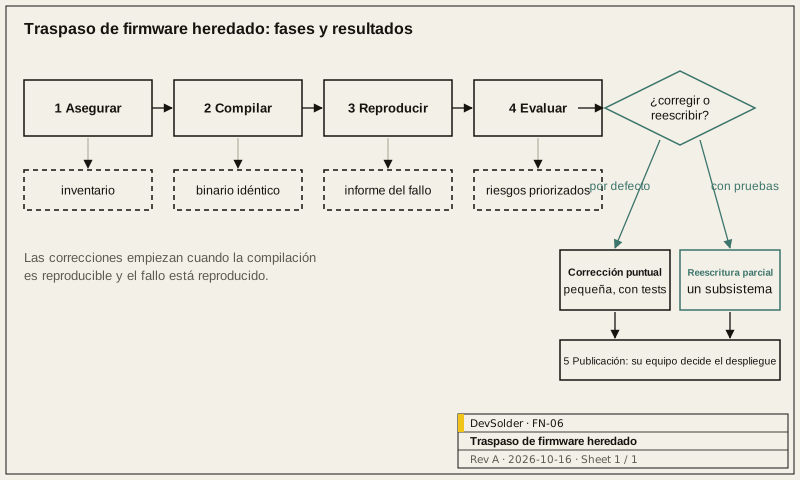
1.0 El punto de partida habitual
Una situación típica: el desarrollador o proveedor original ya no está. El código fuente está en un archivo comprimido, o en parte en el portátil de alguien. La compilación funciona en una sola máquina, con una toolchain que nadie recuerda haber instalado. Hay dispositivos en campo y llegan incidencias: reinicios, bloqueos, una función que falla con un modelo concreto de teléfono. Hay prisa por corregir el fallo.
La tentación es ponerse a leer código y parchear. Sin una compilación reproducible y un fallo reproducido, un parche dirigido a la causa equivocada envía un segundo fallo junto al primero.
2.0 Fase 1: asegurar los activos
Reúna todo antes de que desaparezca:
| Activo | Por qué importa |
|---|---|
| Código fuente, todas las ramas y archivos | Lo obvio; busque más de una copia y compárelas |
| Instaladores de la toolchain y versiones exactas | La versión del compilador cambia la generación de código y los tiempos |
| Scripts de compilación, proyectos del IDE, scripts del enlazador | Contienen opciones de optimización, mapa de memoria y defines que no están en el código |
| Binarios actualmente en campo, con sus versiones | Demuestran qué código corresponde a qué unidades |
| Código fuente y claves del bootloader, si los hay | Sin ellos quizá no se puedan actualizar las unidades |
| Herramientas de programación y procedimiento de la línea de producción | Necesarios para fabricar unidades nuevas |
| Archivos de diseño de hardware de cada revisión de placa | El firmware se ramifica según la revisión de placa |
| Incidencias, registros de campo, correos de clientes | Las pruebas de los fallos |
Ponga el código bajo control de versiones de inmediato si aún no lo está, con el archivo original sin cambios como primer commit. Las claves de firma y las credenciales van a un almacén de claves adecuado, no al repositorio.
Hable con quien trabajó en el producto mientras siga localizable: el desarrollador anterior, la línea de producción, el equipo de soporte. Una hora con el desarrollador anterior puede explicar una rareza de la compilación o un apaño de campo que costaría días redescubrir en el código. Ponga las notas por escrito y guárdelas con el repositorio.
3.0 Fase 2: hacer reproducible la compilación
El objetivo es obtener, a partir del código, un binario idéntico al de campo, o explicar cada diferencia.
- Recrear la toolchain en un contenedor o en una VM documentada, fijando versiones.
- Compilar y comparar la salida con el binario de campo. Las diferencias por marcas de tiempo o rutas incrustadas son esperables; las diferencias en el código, no.
- Si no coinciden, buscar la revisión del código que sí coincida. Si ninguna coincide, anotarlo como hallazgo: el firmware de campo puede contener cambios que nunca se subieron al repositorio.
- Añadir un script de compilación e integración continua para que cualquiera pueda compilar con un solo comando.
La definición del proyecto Reproducible Builds es una buena referencia a la que aspirar. Incluso una reproducibilidad parcial indica si se está trabajando sobre el código que realmente funciona en campo.
4.0 Fase 3: reproducir los fallos
Prepare una o varias unidades de banco que coincidan con las revisiones de hardware de campo. Para cada fallo comunicado:
- Anotar los síntomas y las condiciones: versión de firmware, revisión de hardware, entorno, secuencia de acciones.
- Añadir registro o trazas si el firmware no los tiene, en una compilación aparte que por lo demás coincida con la versión de campo.
- Intentar reproducirlo variando las condiciones sospechosas: calidad de la alimentación, temperatura, entorno radio, funcionamiento prolongado, dispositivos anfitriones concretos.
- Registrar qué se reprodujo, qué no y con qué grado de confianza.
Algunos fallos no se reproducirán en el banco. Ese resultado se indica sin rodeos, junto con las hipótesis y los datos de campo que ayudarían, como una compilación con registro en unidades de campo que usted seleccione.
5.0 Fase 4: mapear y evaluar
Ahora se lee el código con un propósito. Redactamos una evaluación breve que cubre:
| Área | Qué buscamos |
|---|---|
| Estructura | Módulos, capas, cómo se organiza el acceso al hardware |
| Concurrencia | Manejadores de interrupción, tareas del RTOS, datos compartidos, prioridades |
| Memoria | Tamaño de pilas, uso del heap, manejo de búferes, hallazgos del análisis estático |
| Gestión de errores | Qué ocurre ante fallos de periféricos y timeouts, uso del watchdog |
| Vía de actualización | Si las unidades se pueden actualizar y con qué seguridad |
| Pruebas | Qué existe y qué se puede añadir con poco coste |
| Acoplamiento con el hardware | Dependencias de la revisión de placa, números mágicos ligados a componentes |
Las herramientas de análisis estático y los avisos del compilador en niveles altos producen listas largas en código antiguo. Las clasificamos según la probabilidad de que causen los fallos comunicados, en lugar de intentar eliminarlas todas.
6.0 Fase 5: corregir, verificar y publicar
Corrija primero los problemas con mejor relación entre impacto y riesgo, cada uno como un cambio pequeño y revisado, con una prueba que reproduce el fallo antes de la corrección y pasa después. Publique las correcciones en versiones que cambien lo mínimo posible. Su equipo decide cuándo sale una versión y cuándo llega al parque de dispositivos, con las pruebas que le entregamos.
6.1 ¿Corregir o reescribir?
| Indicio | Apunta a |
|---|---|
| Los fallos se atribuyen a unos pocos defectos concretos | Correcciones puntuales |
| Producto en campo con la vía de actualización funcionando | Correcciones puntuales y después refactorización gradual |
| Siguen apareciendo fallos nuevos por la misma causa estructural, como estado compartido sin protección entre tareas | Reescritura parcial de ese subsistema |
| La plataforma de hardware va a cambiar de todos modos | Se puede plantear la reescritura junto con la nueva plataforma |
| No hay compilación reproducible y falta el código de partes clave | La reescritura de las partes que faltan es inevitable |
Reescribir por completo un firmware de campo tiene su propio riesgo: el código antiguo lleva dentro correcciones de problemas que nadie dejó por escrito. Cuando recomendamos reescribir parte del sistema, explicamos por qué y mantenemos el comportamiento anterior como referencia de prueba.
7.0 Qué recibe en cada fase
- Inventario de activos y repositorio con el archivo original como base.
- Compilación reproducible con toolchain documentada e integración continua.
- Informe de reproducción de fallos.
- Evaluación del código con riesgos priorizados.
- Correcciones con pruebas y notas de versión.
Estos entregables sirven tanto si el trabajo continúa con nosotros como si no. La página Firmware heredado y rescate en campo describe cómo empieza un encargo, y Firmware embebido trata el trabajo de firmware nuevo. Para describir su situación, use Hablar de un proyecto.
Referencias
- Reproducible Builds, definition: https://reproducible-builds.org/docs/definition/
Preguntas frecuentes
El proveedor anterior no nos entrega el código fuente. ¿Qué se puede hacer?
Empezar por lo que hay: los binarios, los dispositivos y la documentación que exista. Parte del comportamiento se puede entender a partir de ahí, y la evaluación mostrará qué partes habría que reescribir. Revise también el contrato con el proveedor anterior; puede que ya incluya condiciones de entrega del código fuente.
¿Cuánto tardan en poder corregir el primer fallo?
Depende de lo rápido que la compilación se vuelva reproducible y el fallo se reproduzca. Esos dos pasos varían más que la corrección en sí, así que informamos del avance de cada uno y damos una estimación de las correcciones cuando ambos están hechos.
¿Pueden trabajar sin acceso a unidades en campo?
Empezamos con unidades de banco de la misma revisión de hardware; el acceso a campo solo hace falta cuando el fallo depende de la instalación, el cableado o el entorno de RF. En ese caso, una compilación con registro en unidades de campo que usted elija es la forma práctica de obtener datos.
¿Cambiarán el estilo o la estructura del código?
Solo donde reduzca el riesgo. Las primeras correcciones son pequeñas y siguen el estilo existente para poder revisarlas. Una refactorización mayor se propone aparte, con su motivo, cuando ya hay pruebas.